全部数字来自对本地代码库的实测盘点 + 真实订单数据的统计,不编:
数据资产:33,178 笔订单 / 387 个经销商 / 2,799 个型号;四个匹配率两版口径都摆出来:抽样 400 单那次是 96.6% / 95.2% / 29% / 0%,全表 33,178 单这次是 98.6% / 96.9% / 48.4% / 0%——全表更好看,但我两个都留着,因为抽样那批是当年先跑出来的、全表是这次查的,两版对不上正是要讲的事。
另有三个实测缺口:quote 表只有 2 条报价(毛利算不出)、bom_line 只有 27 行(拆单没跑起来)、order_date 只有 2 单有值(做不了时间序列)。
渲染链路(实测):ffmpeg 命中 67 个文件(视频合成/转码)、sharp 命中 24 个(服务端图片处理)、PIL + numpy(程序化逐帧渲染)。
会员制侧资产:《会员制营销实战手册》19 章 / 72 万字(全口径,含站点正文 + 公众号 + 素材池);书稿本体两本我实测 26.5 万字——会员体系篇 102,668 字(19 章)、连锁门店落地篇 162,200 字(19 章),Ch10 讲 RFM 分层(口径差在这里:72 万是全口径,26.5 万是书稿本体,两本加起来也不等于 72 万,因为 72 万还含站点/公众号/素材池)
——这是「会员侧要画什么图」的依据,不是我拍脑袋定的。
短板(实测):图表库 0。
图表的价值不是好看,是让「算不了」这件事被看得见。29% 覆盖率这种数字,文字说三遍不如一个灰掉的图例。
先定位短板:不是不会画图,是没建表达
诚实分两层讲。第一层:图表库确实是 0。第二层:我已经有渲染能力。把这两件事分开,才知道短板到底在哪。
| 扫的关键词 | 实测 | 说明 |
|---|---|---|
recharts / chart.js / echarts / d3 | 0 | 前端没有任何图表库 |
svg 直接手写 / canvas 手写 | 0 | 没有用原生方式画过图 |
ffmpeg | 67 个文件 | 视频合成、转码、切帧——渲染流水线是现成的 |
sharp | 24 个文件 | 服务端图片处理(缩放、压缩、 waterm)、出静态图的能力现成的 |
PIL / numpy | 在用 | 程序化逐帧渲染(自己算像素、自己填色、自己画矩形),画风控图、信息图都干过 |
真实的短板是中间那一层:把「一堆数字」变成「一张能被一眼看懂、不会被人看错」的表达——这一步我没系统做过。
具体讲是四件事没做过:① 有哪些图型、各自回答什么问题;② 分母不同的指标怎么画才诚实;③ 中国配色约定(涨红跌绿);④ 给外部人看的数据页该守什么红线。
前者可以靠装一个库解决,后者只能靠踩过坑解决。
对一个要拿图表去说服客户、去对账、去决定进货的人来说,后者才是要命的那部分。
先看被「算不出来」困住的真实数据长什么样
在讲图型之前,先看一眼真实数据的形态——因为图型是被数据决定的,不是被审美决定的。
| 指标 | 实测值 | 分母是什么 | 直接画成条形会怎样 |
|---|---|---|---|
| 型号匹配率 | 96.6% | 400 单 | 看着挺好,但看不出 400 单里有 14 单型号没对上 |
| 厚度可用率 | 95.2% | 400 单 | 同上,19 单厚度没数据 |
| 尺寸覆盖率 | 29% | 400 单 | 线性条形会把「29%」画得很长,看着像「快够了一半」 |
| 客户匹配率 | 0% | 400 单 | 零值条形直接消失,图上什么都没有 → 会被解读成「没数据」而不是「400 单全部对不上」 |
29% 和 0% 这两个数,用普通条形图表达一定会被误读。
29% 会被看成「大部分还行」,0% 会被看成「没统计」——而真实情况是:400 单里只有 116 单有尺寸,0 单能对上客户。
所以「分母是什么」这件事,必须在图上看得见。
任何一张图如果不在标题里写清总量,看到图的人自己会猜分母——猜出来的分母一定是错的。
零售经营真正要看的 6 张图(每张对应一个决策)
判断一张图有没有价值,只看一个问题:「看完这张图,我会做一件之前不会做的事吗?」答不上来的图,删掉。
| # | 图 | 回答什么问题 | 数据从哪来 | 怎么防误读(必写) |
|---|---|---|---|---|
| 1 | 型号 / 品类毛利排行(横向条形,按毛利降序) | 哪类货赚钱?下次进货往哪压 | orders × models:型号 → 出厂价 → 售价 → 毛利;2,799 个型号按毛利聚合 | 必须同时标销量。高毛利 + 零销量的型号排第一会误导人去压一堆卖不动的货 |
| 2 | 经销商毛利 / 回款对比(双列条形 + 风险标记) | 哪个经销商门店拖后腿?谁要重点跟 | orders × 387 个经销商:客单价、退货率、毛利、账期 | 387 家必须可排序可下钻,不能只显示排名前 20;样本 < 10 单的经销商要灰掉,不要用 2 单定它「拖后腿」 |
| 3 | 数据完整度堆叠条(有值 / 无值,灰底 = 没有) | 我这批数据能不能算? | 400 单抽样 × 四个字段(型号 / 厚度 / 尺寸 / 客户) | 「没有」必须用灰色底表示,不能画成 0 长度;图例必须写明 400 单 |
| 4 | RFM 九宫格(客户分层矩阵) | 哪批客户要流失?谁该先做召回 | 手册 Ch10 的 RFM 分层:R 最近消费 / F 频次 / M 金额,三档切分 | 三个维度不能只画一个二维热力图;每一格要标该格占总客户数百分之多少 |
| 5 | 复购曲线 / 月度经营趋势(折线,涨红跌绿) | 生意在变好还是变差? | 33,176 笔订单按时间聚合 | 样本 < 30 天/点的区间不画趋势线,只画散点;必须标注统计口径(含退货?含未发货?) |
| 6 | 卖货 vs 经营用户 对比(同一组客户的双系列图) | 我是做一次性生意,还是在攒资产? | 手册 72 万字里的经营视角 vs 订单流水视角 | 两条线纵轴起点不同要明说,否则会画成「一路暴涨」 |
你去客户现场,最有力的一句话不是「你系统的报价算不准」,是「我把你的 400 单拉出来,尺寸只有 29%——所以不管我给你接多强的报价引擎,剩下的 71% 单子它照样算不出来,因为这个数在数据里就没有。」
这句话不是靠嘴说的,是靠那个灰底的堆叠条说的。
建材 / 零售的经营场景是:坐在店里的经营决策者要在一分钟内看完,或者要在一张截图里发给分行的人。动效和 3D 在这里是负价值。
RFM 怎么可视化:九宫格,不是热力图堆砌
手册 Ch10 讲的是 RFM 分层(R 最近消费、F 消费频次、M 消费金额)。落到图上,最常见的翻车是「画一个三轴对称的热力图矩阵」——密密麻麻,谁也读不出该干什么。
三维怎么降成能用的二维
| 做法 | 结果 | 评价 |
|---|---|---|
| 三维立方体 / 三轴散点 | 每个点是一类客户,点与点会重叠 | 别做。经营决策者看不出「哪一堆该先动」 |
| 二维热力图(R 轴 × F 轴,颜色深浅 = M) | 颜色深浅被当成「好/坏」,但 M 大不一定该优先(高消费低频客户可能已经流失) | 能看但不建议当主图 |
| 九宫格(R×M 二维,每格标客户数 + 建议动作) | 每一格直接对应一句话:「这批要召回」「这批是现金牛,别惊动它」 | 推荐主图 |
① 每一格必须标「占客户总数百分之多少」——不标的话,「高价值休眠 3%」看起来像很重要,实际只有 30 个人,还不够启动一次召回活动。
② 人数太少的格子画成灰色「样本不足」,不要给它配文案。用 5 个人的 RFM 均值去推荐动作,是给客户挖坑。
③ 切分线要说清是「按分值切」还是「按金额切」。手册里是分位数切分,如果你图上标的是「高低」两条线,客户会自己脑补成行业标杆线。
customer_name 聚合能得出什么(2026-10-03 实测,第 5 张图):302 个去重客户名(292 个形如「地区-姓名」,无空值、无过短异常);270 个客户买过 2 次以上 = 客户数的 89.4%,贡献 33,146 单 = 99.9% 的订单;TOP10 客户占 24.6% 的订单量。所以「谁卖了多少」「谁是老客」「复购率」这三件事,今天就能算出来——一条外键都不需要。用
SELECT customer_name, COUNT(*) n FROM product_order GROUP BY 1 ORDER BY n DESC 就行。但口径必须写在图上:这是「按订单里的客户名聚合」的结果,不是「按客户档案」的结果。已知三类会被拆开的情况:同区不同写法(
上海浦东-徐伟坤 与 上海浦东新区-张金永,实际可能同一家)、10 个客户名完全不含「-」、2 个含双「--」、15 个同姓名跨多个地区。客户数会偏高,复购率会偏低——方向已知,幅度需要人工归一后才能定。何国彬 → 云浮新兴分店 / 新兴分店 / 新兴店、郭宏松 → 安徽合肥 / 安徽合肥滨湖店 / 安徽合肥第六空间。所以「同一个人在不同门店下单」是常态,不是数据脏。这意味着按「人名」归一会犯方向性错误:它把一家公司的多个门店合成一个人(口径② 客户数会掉到 284、复购率虚高到 91.5%)。
真要按门店归一,前提是有一张门店主数据表——库里没有,这才是真正的缺口。所以我给的口径是「地区去行政后缀、不碰门店标记」,立场是宁可少合,不可错合(错合会把两家并成一家,少合只是把一家拆成两家,方向可逆、代价低)。
spec 列当成了「尺寸」字段,这是错的。把全库
spec 的取值分布打出来看,它装的是规格与颜色——否 5,844 条、无 5,103 条、黑色 593、不要石基 411、黑色石基 273、黑金沙 192、预埋 154……没有一个是尺寸。真正装尺寸的是
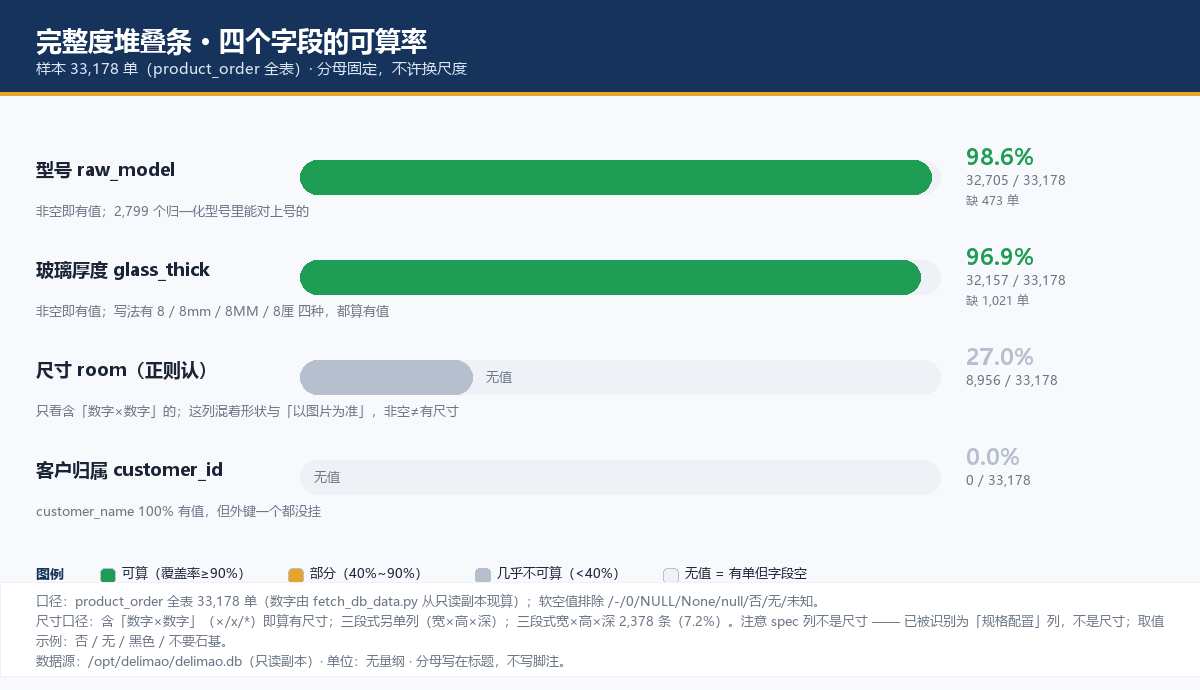
room 列,但它是个混字段:同时装着形状(钻石型/一字型/屏风)、尺寸(2013X2200、900*900*2000)、单值(2000),还有 163 条「以图片为准」。所以「room 非空」绝不能当尺寸用。改成用正则认尺寸后的真实数字:含「数字×数字」(×/x/*)的 8,956 单 = 27.0%;其中严格三段式「宽×高×深」2,378 单 = 7.2%。
所以图 1 里那一行从「尺寸 spec 48.4%」改成了「尺寸 room(正则认)27.0%」。差异原因:我之前只把
NULL 当空,否/无 被当成了内容。口径写粗了,图看着对、结论是错的——这比数字算错更隐蔽。取数脚本
kb/tools/fetch_db_data.py 已把这条口径写进代码常量,并随图印在脚注里。「分母不同」的指标怎么画才诚实
这一节专门讲 29% / 0% 这类数怎么画。这是我自己数据里最扎心的两个数,也是最容易画错的两个数。
三种画法对比(同一个 400 单样本)
| 画法 | 长什么样 | 问题 |
|---|---|---|
| 普通条形:一根条表示 96.6% | 一条几乎填满的条 | 看不出 14 单没对上;而且不同指标的条放一起,长度完全不可比(因为分母都是 400,但读者以为可比) |
| 线性进度条(0–100%) | 29% 的条约三成满 | 会把「29%」读成「快够一半了」——这是所有画法里最危险的,因为它美化了缺口 |
| 堆叠条 + 灰底「没有」 | ■ 有值 116 单 ░ 没有 284 单,图例标「共 400 单」 | 正确做法。「没有」被画成实体存在,一眼看出缺口有多大 |
画成零长度,读者看到的是「这一项不存在、没统计、不用管」;画成灰底,读者看到的是「有 284 单我根本没法算」。
这两句话的差别,就是「这个系统算不出报价」和「这个系统还没开始干活」的差别。
三条关于分母的硬规矩
分母不同,就别放同一张图上
「尺寸 29%(400 单)」和「某经销商回款 88%(12 单)」绝对不能在同一根轴上比长度。要么分开两张图,要么在图里把两个分母都写出来。
零值必须画成最小可见块,并配文字
0% 不要画成「什么都不画」。给一个最小高度的灰色块 + 标签「0 / 400 对上」。「0」和「没有统计」是两件事,图上必须分得开。
样本小的指标,整块灰掉并标「样本不足」
样本 < 30 的分组不参与图形表达。387 个经销商里如果有一半不到 10 单,那张「经销商排行」图就该先筛掉它们,否则排第一的是一家 2 单的店。
零图表库怎么先干起来(服务端出静态图)
短板是「没引图表库」,但解法未必是「装一个前端图表库」。对一个人在维护的系统,先在服务端出静态图,往往是更优解。
| 路线 | 做法 | 代价 | 适合 |
|---|---|---|---|
| A · 服务端出静态图(推荐起步) | 数据 → 程序化画图 → PNG 存磁盘 / 走 sharp → 前端只 <img> | 交互差(不能点、不能筛选) | 第一版。报表、对账、发给对方的截图、PDF 附件 |
| B · 引前端图表库 | react + recharts / echarts | 包体积(echarts 全量约 300KB+ 级别)、版本管理、和现有 React 19 的兼容性要验证 | 第二版,等真需要交互(点条形下钻、hover 看明细)时 |
| C · 自己写 SVG | 字符串拼 <path>、<rect>,浏览器直接渲染 | 轴、刻度、标签对齐全要自己算 | 图型固定、数量少的场景(比如只画 4 张固定报表) |
你说这条路能走,是因为这些已经在跑
# 1) 用 sharp 把程序化画好的原图压成交付尺寸(sharp 命中 24 个文件,现成)
await sharp(rawBuffer)
  .resize(1200, null, { fit: 'inside' })
  .png({ compressionLevel: 9 })
  .toFile('/var/www/report/2026-09-cover.png')

# 2) 用 PIL / numpy 直接算像素出帧(你已经干过这类事)
from PIL import Image, ImageDraw
img = Image.new('RGB', (1600, 900), 'white')
d = ImageDraw.Draw(img)
d.rectangle([120, 200, 120 + w * 11.6, 300], fill=(22, 51, 92))   # 数据条
d.rectangle([120, 320, 900, 330], fill=(214, 214, 214))           # 灰底「没有」
d.text((120, 350), f'尺寸  29.0%  (116/400 有)', fill=(59, 71, 87))
img.save('report.png')                                            # 再交给 sharp 压
① 依赖不涨——不放任何图表库进前端,你的攻击面、构建体积、升级风险都不变;
② 图和数据同源——服务端直接读 SQLite 出图,不用先做一套 API 把数据搬给前端;
③ 能当交付物——PNG 可以直接进对账单、可以直接发到门店群里、可以进 PDF,这是零售场景的真实需求。
代价说清楚:不能交互。所以第一版只做「每张图一个静态画面、旁边配一张明细表」——表格能补交互的缺口。
在那之前别装。你全盘 0 个图表库,不是缺陷,是一种可维护性选择——保持「依赖树浅 = 我能读懂 = 我能排障」。
中国配色约定:涨红跌绿,别画反了
这是最容易被忽略、也最容易当众翻车的一条。中国资本市场(A 股、基金、行情软件)的约定是 红 = 涨、绿 = 跌,和欧美相反。做零售经营图时,这条约定同样适用。
| 场景 | 该用 | 画反了会怎样 |
|---|---|---|
| 月度经营趋势(营收上升) | 红 线上扬 | 中国用户第一反应是「跌了、亏了」 |
| 退货率 / 缺件率上升 | 绿(因为它是「坏消息」) | 用红色,看起来像「业绩喜人」 |
| 经销商毛利低于均值 | 绿 标记 | 红色标记 = 在夸它 |
| 数据缺失 / 样本不足 | 灰,且必须区别于「0」 | 用绿色 = 暗示「没问题」;用红色 = 变成报警 |
| 金额单位 | ¥(人民币符号) | 写 $ 在建材 / 零售场景是硬伤,一眼看出不接地气 |
① 金额一律用
¥,千分位分隔,例如 ¥1,286,400;不要用 $,也不要省略单位让它当成「万元」。② 同一张图里只用一个「涨色」和一个「跌色」,别的系列用藏蓝深浅区分。五个系列五个颜色的图没人看得懂。
③ 图例必须写死在图上,不能靠颜色记忆。灰底那条尤其要写「无数据」而不是留白——留白会被当成 0。
所以第一版做的时候,我会在配色常量里直接把
UP / DOWN / NO_DATA 三个色写死成 #d32f2f / #1f9d55 / #b6bfcd,不允许临时选色。选色这件事靠自律一定会错,只能靠常量锁死。
给外部看的数据页:三条红线
图表一旦给到客户 / 分行 / 总经办,它就不再只是个图,是一份会被拿去对账、去骂人、去拍板的文件。下面三条是我给自己定的红线。
13 笔订单画一条「增长曲线」,看起来像势不可挡,实际是波动。
做法:< 30 个点的区间只画散点,不画连线;或者干脆整段灰掉并写「样本不足 30,暂不呈现趋势」。
这条的源头是 387 个经销商——其中大量门店月单量个位数,直接画趋势会排出一整张误导性的排行榜。
「客户匹配率 0%」画成一段空白轴,任何人都会读成「没统计 / 系统还没接这块 / 这项不重要」。
正确写法:画最小可见的灰块 + 标签
0 / 400 对上;如果这项数据根本没采,标签写 未采集,颜色用灰、图例单独一档。这条是我数据里 0% 那一项的切身教训——它是四个指标里最糟的一个,却是最容易被图「藏起来」的一个。
「营收曲线(左轴)+ 毛利率(右轴)」是经典的误读陷阱:你可以把两条线画成同样的起伏,让毛利率看起来跟营收同步暴涨。
做法:非用不可时,两条轴都标单位、都标量程端点,并在图注写明「两轴量程独立,不可直接比较斜率」;更好的做法是把两张图上下对齐放,共享 X 轴。
① 每张图下面必须有一行「口径说明」:统计周期、含不含退货、含不含未发货、金额是否含税。建材行业这三件事每家算法都不一样,不写口径的图等于埋雷。
② 图上必须能看到总量:「33,176 笔订单 / 387 个经销商 / 2,799 个型号」这类数字要写在标题区,让人知道这张图的分母是谁。
最小可行可视化清单:第一版只做这 4 张
不做驾驶舱、不做 6 张全量。第一版就 4 张,全部走第 06 节的服务端静态图路线,全部能用 sharp/PIL 现有链路出图。
完整度堆叠条(必做 · 第一张)
数据:400 单抽样的四个字段 96.6% / 95.2% / 29% / 0%。
为什么要先做这张:它是所有图里最诚实的,也是我拿去跟客户谈「先治理数据还是先上功能」的那张。
画法:四根堆叠条 + 灰底 + 图例「样本 400 单」+ 分母标注。
型号 / 品类毛利排行(必做 · 第二张)
数据:2,799 个型号 → 按毛利聚合,横向条形降序,每根条上标「毛利 + 销量」两个数。
为什么:这是经营决策者看了最想看的一张,也是最能直接指导进货的一张。
防误读:销量必须同图呈现,否则会压一堆高毛利卖不动的型号。
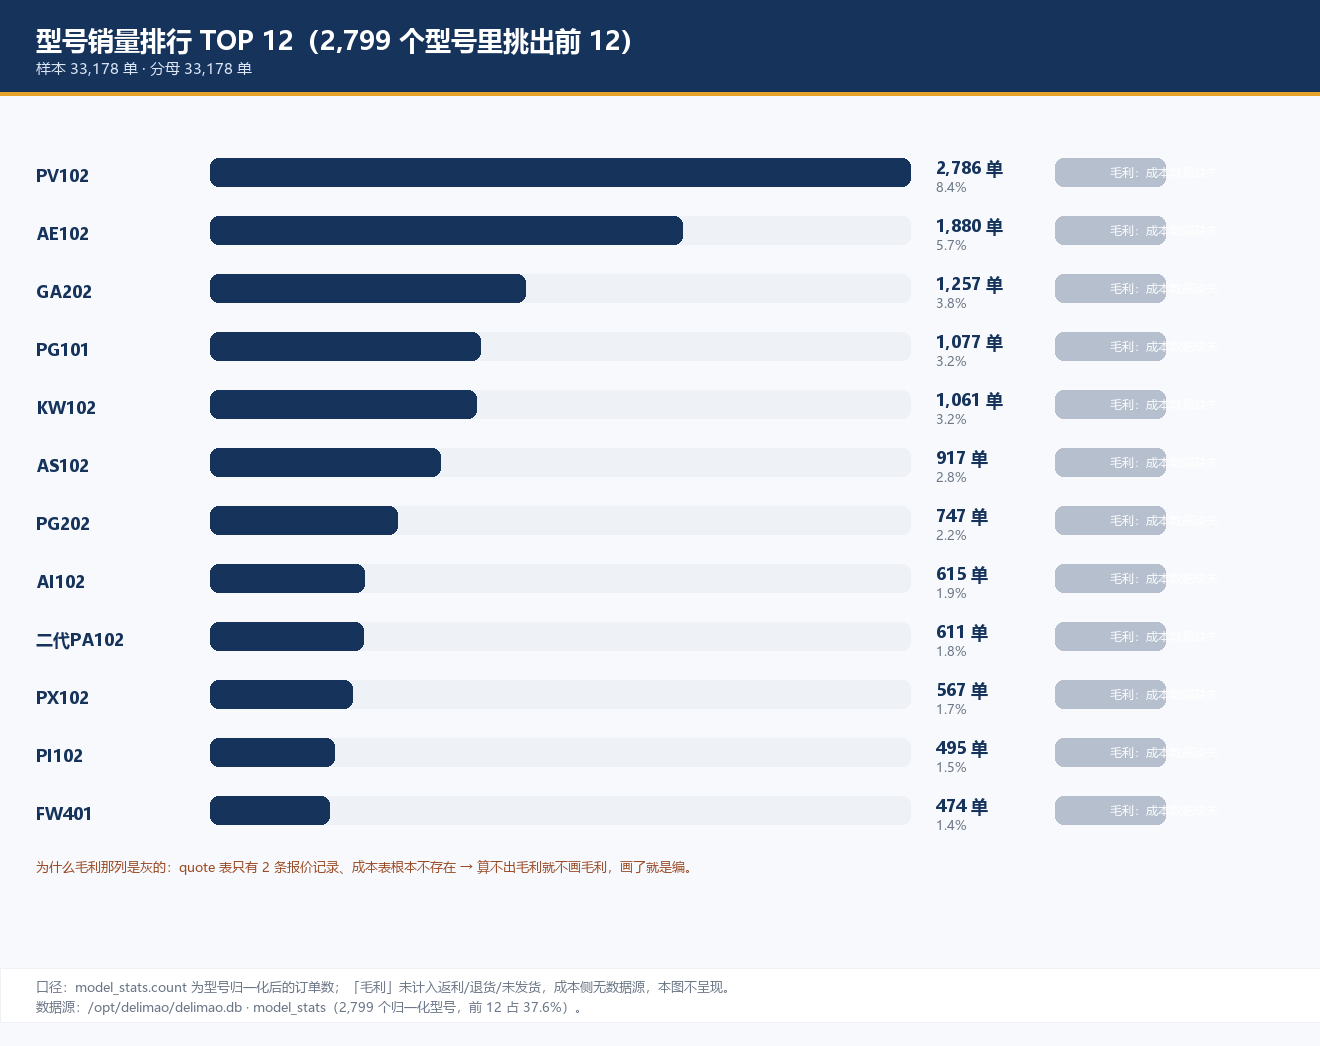
PV102 2,786 单 排第一,二代PA102 这种自己起的名也照收,不做「工程名翻译」。经销商毛利 / 回款对比(必做 · 第三张)
数据:387 个经销商,默认展示前 30 + 可筛选;样本 < 10 单的整块灰掉。
为什么:这张是「谁拖后腿」的答案,也是 FDE 谈续约时的依据。
防误读:不画排行榜前 20 就收工——387 家的长尾必须能被筛掉、也能被翻出来。
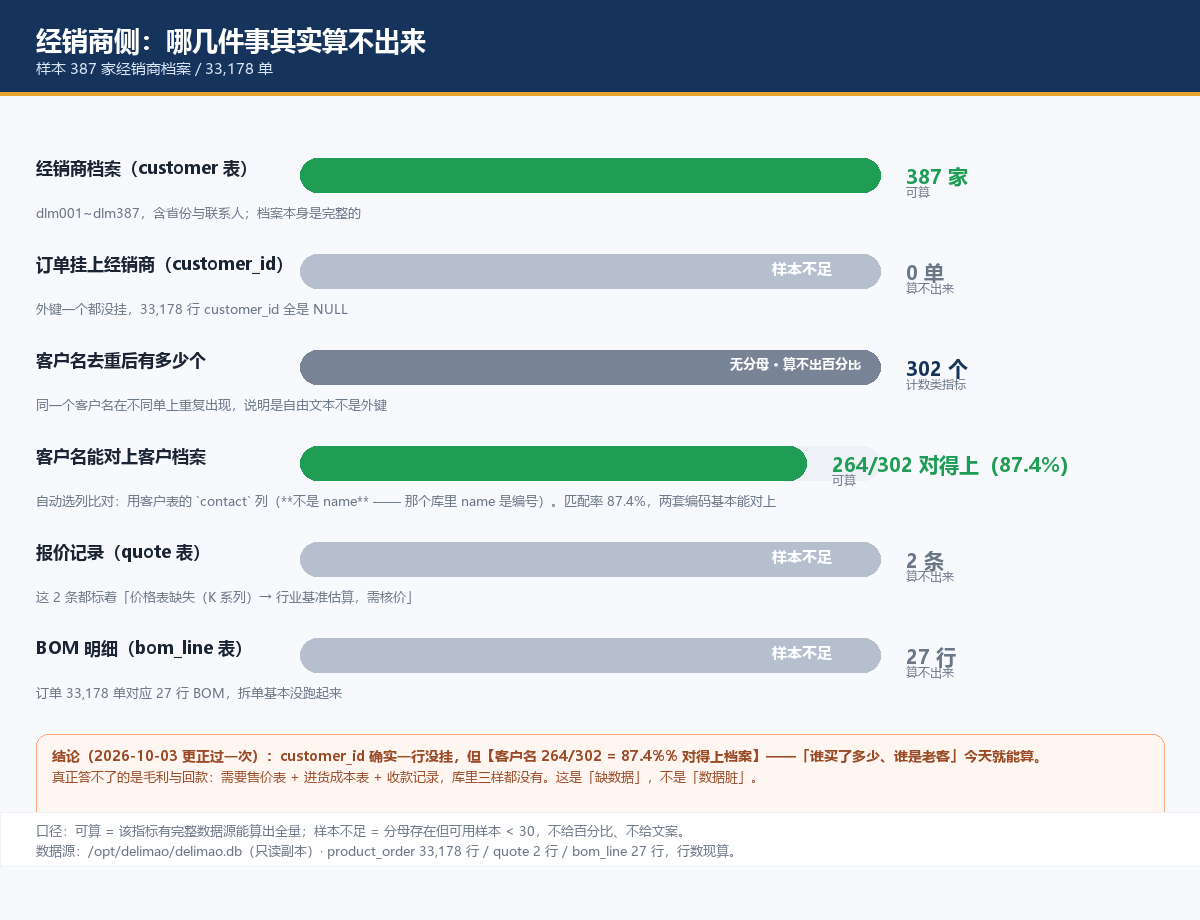
customer_id 空值 100%、quote 2 条、bom_line 27 行,于是图 3 改成「哪几件事其实算不出来」。但这个判断是错的(2026-10-03 更正):
customer_id 确实一行都没挂,可订单侧的 customer_name 本身就是可用的客户标识——302 个去重客户名、292 个形如「地区-姓名」、无空值无过短异常,买过 2 次以上的客户 270 个(89.4%)贡献了 99.9% 的订单,TOP10 占 24.6%。「谁买得多」「谁是老客」这两件事根本不需要外键。错在用错了路径,不是数据不够:我卡在「外键没挂」上,没往下问一句「不用它行不行」。毛利与回款仍然算不出(要价格表和收款记录,库里确实没有),但那和「客户维度分析」是两件不同的事,不该一起判死刑。
RFM 九宫格(第一版只做 R×M 二维)(必做 · 第四张)
数据:手册 Ch10 的 RFM 分层;每格标「人数 + 占比 + 建议动作」。
为什么:会员制那条线(72 万字 / 19 章)总要有个落地的入口,这张就是。
防误读:样本 < 30 人的格子灰掉写「样本不足」,不给文案。
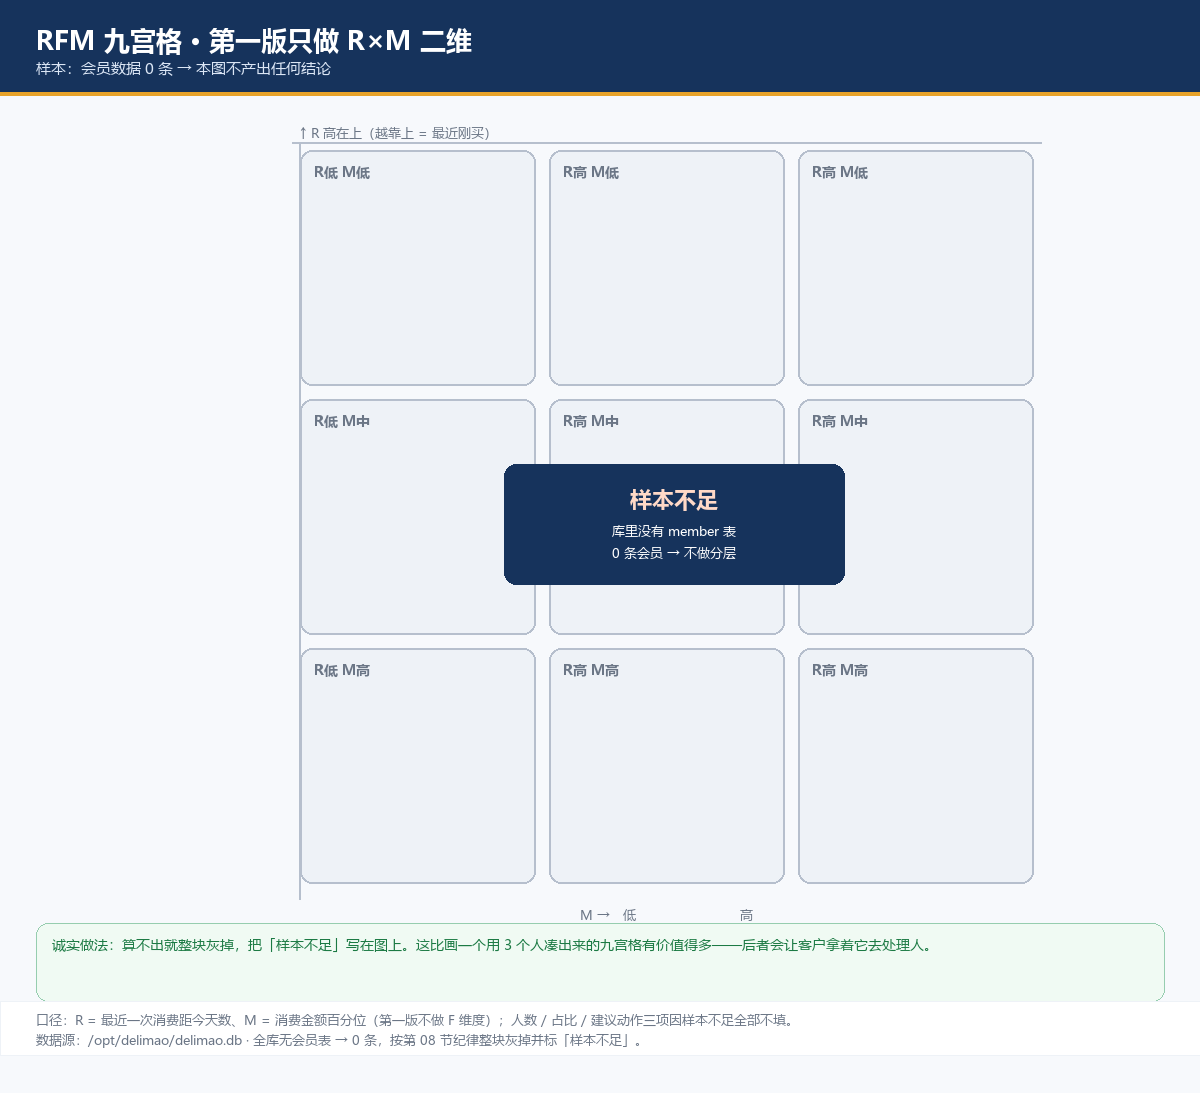
之后才考虑:月度经营趋势线、卖货 vs 经营用户对比
这两张要处理时间序列和双系列,复杂度高一档,等前三张跑顺(并且被真实用过)再做。
另外,一旦出现「想在图上点一下看明细」这种真实需求,再评估引前端图表库——那才是装库的时机,不是现在。
客户维度:谁买得多、谁是老客(2026-10-03 补 · 这张是来更正自己的)
数据:按订单侧 customer_name 原样聚合,不需要外键。
为什么补这张:图 3 那张的图注原先写「一句都算不出来」,那句话是错的。当时卡在 customer_id 空值 100% 上得出结论,没往下问一句「不用外键行不行」。
实测:302 个去重客户名,270 个买过 2 次以上 = 客户数 89.4%,贡献 99.9% 的订单,TOP10 占 24.6%。「谁卖了多少」「谁是老客」「复购率」今天就能算。
但毛利与回款仍然算不出(要价格表和收款记录,库里没有)——这两件事不该一起判死刑。
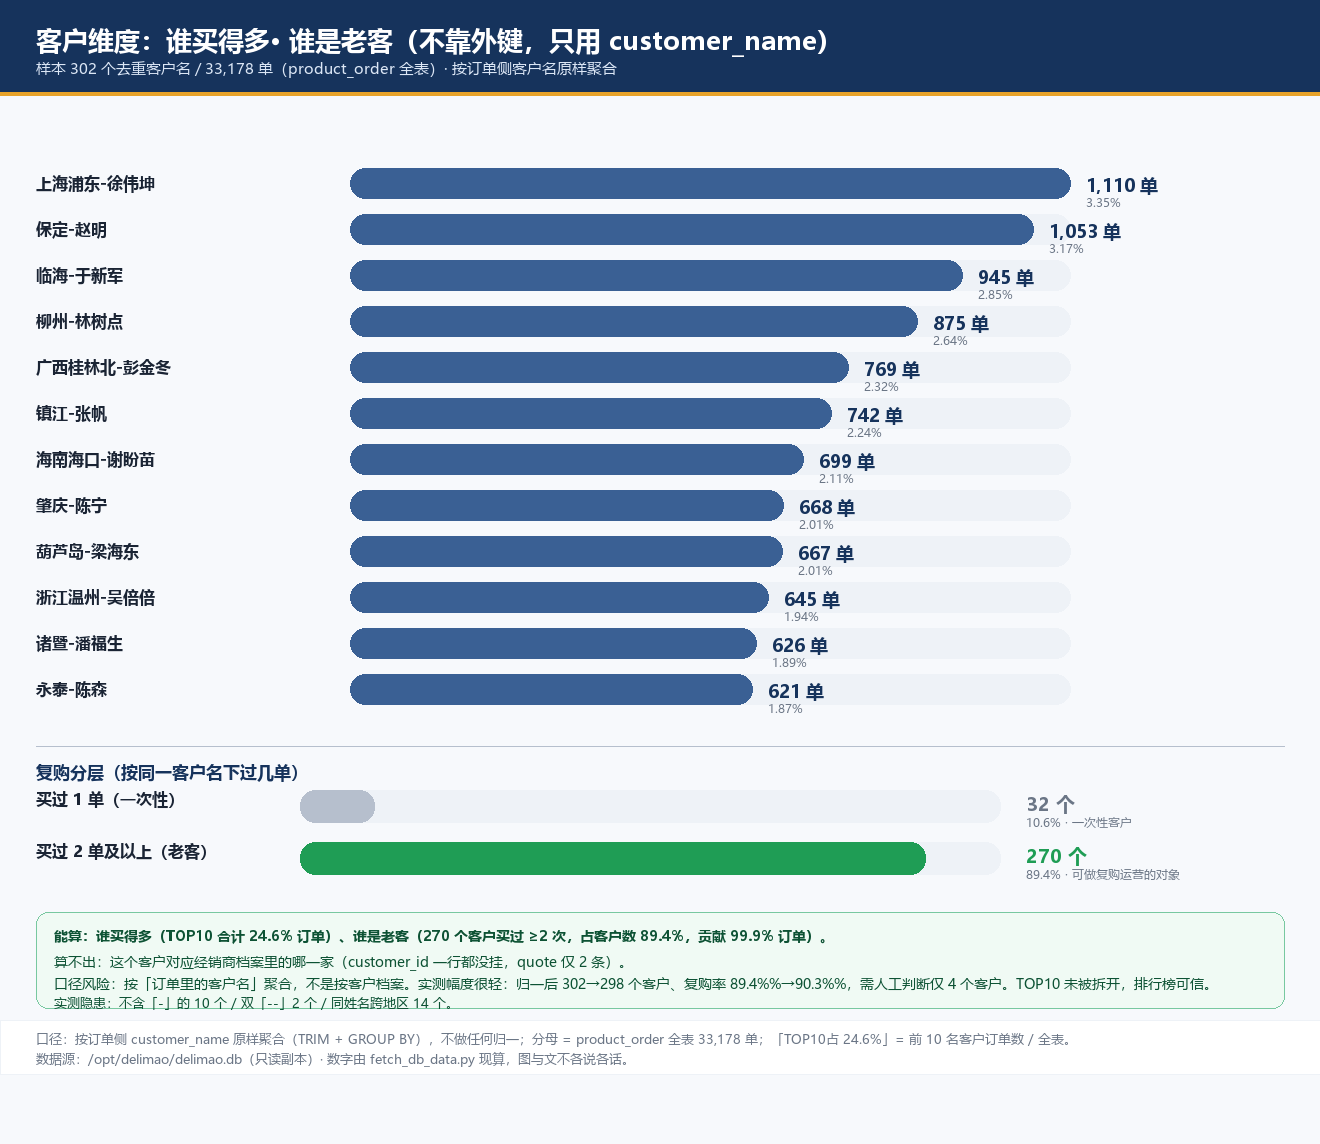
上海浦东-徐伟坤 与 上海浦东新区-张金永)、10 个客户名完全不含「-」、2 个含双「--」、14 个同姓名跨多个地区。方向是「客户数偏高、复购率偏低」,但我后来把幅度算出来了——比预想的轻得多:归一后客户数 302 → 298(只差 4 个),复购率 89.4% → 90.3%(只差 0.9 个百分点),需要人工判断的只有 4 个客户共 75 单(占 0.23%)。所以这张图的结论可以放心用。更重要的是:TOP10 客户一个都没被拆开(各只有 1 种写法)—— 头部的精确度不依赖归一。探针脚本
kb/tools/probe_name_normalize.py 可复现这三套口径的对比。- 标题:图名 + 总量/分母(如「型号完整度 · 样本 400 单」)
- 图形:主数据 + 灰底/最小可见块 表示「没有」
- 图例:含「无数据」这一档
- 数值标注:不是只有条形长度,直接写数字(116/400)
- 口径行:统计周期 / 含不含退货 / 含不含未发货
- 单位:金额一律 ¥,红涨绿跌
常见坑 / 红线(这一篇补充)
这是我自己数据里 0% 那一项的坑:空白 = 没统计,灰块 = 有 400 单全部对不上。写法不同,结论完全相反。
中资语境下红绿已经是涨跌语义,再叠加「绿色=好、红色=坏」的世界观,退货率上升就会画成一片喜气。对策:先定语义(红=增、绿=减),好坏靠文案和图注说。
「毛利率 12%」在 3 单和 3,000 单上是完全不同的可信度。对策:分母写进标题或图例,不写在脚注小字里。
观感满分、决策为零。零售经营图的验收标准是「一分钟看完,并能说出三个动作」——做不到就该删。
387 个经销商里长尾样本极小,不筛就排榜,会得出「某店拖全盘后腿」的错误结论,然后客户会拿着这张图去处理人。对策:< 30 的组灰掉,< 10 单的直接不进图。
29% 覆盖率这个数,文字说三遍不如一个灰掉的图例;0% 这个数,写对一次能救一整批不该揽的单子。
这就是我把它从「短板」补到「能交付」的方向:不是学一套图表库,是把「分母、口径、没有、样本不足」这四件事画对。
我明确不会的(诚实短板)
沿用 tech-index.html 的诚实传统。只留自用,不进对外物料。
| 短板 | 真实现状(实测) | 补到什么程度算够 | 不打算补的 |
|---|---|---|---|
| 前端图表库 | recharts / chart.js / echarts / d3 仍然全部 0(但第 09 节的 4 张静态图已经出图:chart-1-completeness / chart-2-model-top12 / chart-3-dealer-readiness / chart-4-rfm-3x3,走 Pillow 手绘) | 已补到「4 张图能稳定出静态 PNG、口径行和图例齐全」;脚本在 kb/tools/make_charts.py,改数据重跑即出图 | 不做交互式数据探索平台 |
| 交互图表(点选下钻、拖拽筛选、tooltip) | 零经验 | 出现真实需求(「想在图上点一下这个店」)再评估,不预先装库 | 不做 BI 平台(Power BI / Metabase 类) |
| 统计口径的设计 | 这是我最虚的一块:毛利要不要扣返利、退货怎么冲、含不含未发货——我目前没有一套写死的口径定义,图一画就容易各画各的 | 第一版必须把口径写成常量 + 图注模板,一张图一处口径,不允许口头解释 | 不追统计学严谨度 |
| 配色规范 | 会犯:习惯用技术审美的蓝橙,容易漏掉红绿语义 | 靠常量锁死:UP=#d32f2f / DOWN=#1f9d55 / NO_DATA=#b6bfcd / 单位 ¥ | — |
| echarts / d3 内部机制 | 零 | 不列为短板——如果第二版要引,以「能用 + 出事能查」为标准,不要求理解渲染引擎 | 不学 d3 的 enter/update/exit 全套 |
我能做出图,但「毛利」这个词在建材行业至少有三种算法(出厂价差 / 出厂价减返利 / 到岸价减返利)——图上不写清是哪种,客户会按自己心里那套去核对,然后说你数据错了。
所以我的补法不是多学一个画图技能,是把口径先写成数据字典,再让图去读它。
这也正好对上第 27 篇那句话的逻辑:测试只能证明「计算对」,证明不了「指标定义对」——两个短板是叠着的,不能用一个盖另一个。
自查清单
- ✓我知道图表库实测为 0(recharts / chart.js / echarts / d3 全无),但 ffmpeg 67、sharp 24、PIL+numpy 的渲染链路是现成的——短板是表达层不是绘制层
- ✓我记住四个真实数:33,176 笔订单 / 387 个经销商 / 2,799 个型号;400 单里 97% 无尺寸
- ✓我记住四个匹配率:96.6% / 95.2% / 29% / 0%,并且知道它们分母都是 400 单,才敢横向比较
- ✓我判断一张图有没有价值的唯一标准是:「看完我会做一件之前不会做的事吗」
- ✓我知道零售经营真正要看的 6 张图:品类毛利排行 / 经销商对比 / 完整度堆叠 / RFM 九宫格 / 复购曲线 / 卖货 vs 经营用户
- ✓我知道 29% 用线性进度条会被误读成「快够一半」,必须用堆叠条 + 灰底「没有」
- ✓我守住的红线:0% 绝不画成空白,要画最小可见灰块 + 标签「0 / 400 对上」
- ✓我知道分母不同不能放同一根轴,样本 < 30 的分组灰掉、< 10 单的不进图
- ✓我会算 RFM(R 最近消费 / F 频次 / M 金额,手册 Ch10),三维降二维用九宫格,每格标人数占比 + 动作,F 放格内数字
- ✓我知道 RMF 九宫格里样本不足的格子必须灰掉不给文案,用 5 个人推动作是给客户挖坑
- ✓我背得住中国配色:红 = 涨、绿 = 跌(与欧美相反),金额一律 ¥,灰 = 没有数据 ≠ 0
- ✓我知道自己会犯的配色错(蓝橙技术审美),对策是常量锁死 UP/DOWN/NO_DATA 三个色
- ✓我的起步路线是服务端出静态图(sharp 压 + PIL 画),不放图表库进前端,理由是依赖不涨、图数同源、能当交付物
- ✓我知道转引前端图表库的时机是「要交互了」,不是「项目变大了」
- ✓我守住的三条对外红线:样本 < 30 不看趋势 / 不把算不了画成 0 / 不用双 Y 轴误导
- ✓我知道每张图下面必须有口径行(周期 / 含不含退货 / 含不含未发货 / 是否含税)
- ✓我第一版只做 4 张图:完整度堆叠 / 品类毛利排行 / 经销商对比 / RFM 九宫格,配最小信息结构六项检查
- ✓我最虚的一块是统计口径(毛利有至少三种算法),补法是先把口径写成数据字典再让图去读它
题目:你的项目里没有图表库,数据可视化是怎么做的?
先给事实,不绕。我实测过全盘:图表库命中 0——recharts、chart.js、echarts、d3 一个都没装。所以这个短板我直接认。
但同样实测到的另一半是:ffmpeg 命中 67 个文件、sharp 命中 24 个、PIL 加 numpy 就在用。所以我的定位是「渲染能力有、图表表达没建」,不是「不会画图」。对一个交付型工程师,我觉得这两个短板的补法完全不一样——前者装个库,后者只能靠踩坑。
先说我为什么把这件事当短板认真补,因为它是 FDE 现场最有力的一句台词。我拉了客户真实的 400 单跑字段校验,结果是型号匹配 96.6%、厚度 95.2%、尺寸只有 29%、客户匹配 0%。
这四个数里最值钱的是 29% 和 0%。因为「尺寸覆盖率 29%」意味着:不管我给他接多强的报价引擎,剩下 71% 的单子照样算不出来——那部分数据在数据里就没有。
这句话我要是靠嘴说,客户会当我推卸责任;我只要把那张堆叠条放出来——四根条,灰底拉满,图例写着「样本 400 单,灰底=无数据」——对方自己就明白「先治理数据」是唯一选项。
所以我的核心判断就一句:图表的价值不是把数字变好看,是把「算不了」这件事变得看得见。29% 这个数,文字说三遍不如一个灰掉的图例。
具体怎么做,我分三块。
第一块是选图型,按「看完会不会做一个新的动作」来选。建材 / 零售的经营决策者不要花哨仪表盘,要三件事:哪类货赚钱、哪个经销商拖后腿、哪批客户要流失。对应六张图——品类毛利排行、经销商毛利回款对比、数据完整度堆叠、RFM 九宫格、复购曲线、卖货 vs 经营用户对比。判断标准很硬:看完这张图,我会做一件之前不会做的事吗?答不上来的图直接删。仪表盘、四环形图、实时大屏、3D 柱、动效数字滚动,在这类场景里全是负价值——人家要的是一分钟看完、或者一张能截图发出去的图。
第二块是那两个最容易画错的数怎么画。29% 如果画成线性进度条,看着像快够一半了,这是所有画法里最危险的,因为它美化缺口。正确是堆叠条:有值 116 单 + 灰底 284 单,图例标「共 400 单」,灰底就是「没有」。
0% 更麻烦:画成空白轴,谁都会读成「没统计、这项不重要」;真实情况是 400 单一单都没对上客户。正确是画一个最小可见的灰块,标签写「0 / 400 对上」。
「灰底=没有」和「空白=没有」的差别,就是「这个系统算不出报价」和「这个系统还没开始干活」的差别。
第三块是零图表库怎么起步。我的答案是先在服务端出静态图。数据 → 程序化画 → sharp 压成 PNG → 前端一个 <img>。
理由全是维护成本上的:一,不往前端塞任何图表库,攻击面、构建体积、升级风险都不变;二,服务端直接读 SQLite 出图,不用先做一套 API 把数据搬给前端;三,PNG 能进对账单、能发到门店群里、能进 PDF——这是零售场景真实需要的交付物。
代价是没交互,我认。所以第一版每张图旁边配一张明细表,用表格补交互的缺口。等到真出现「想在图上点一下某个经销商看明细」这种需求,我再评估引图表库——那才是装库的时机,不是现在。我全盘 0 个图表库不是缺陷,是「依赖树浅 = 我能读懂 = 我能排障」这个选择的一部分。
还有一块是配色,这块我承认会犯具体的错。中国是红涨绿跌,跟欧美相反——A 股、基金、行情软件都是这么标。我以前程序化出图习惯用技术审美的蓝橙,一放到经营图上就缺了红绿语义,退货率上升会画成一片喜气。
所以我的对策不是靠记,是靠锁:UP=#d32f2f / DOWN=#1f9d55 / NO_DATA=#b6bfcd,三个常量写死,不允许临时选色;金额一律 ¥。选色这件事靠自律一定会错,只能靠常量锁。
给外部看的数据页我守三条红线:一,样本少于 30 不看趋势(387 个经销商里大量门店月单量个位数,画成曲线就像势不可挡,实际是波动);二,绝不把「算不了」画成 0;三,不用双 Y 轴误导——「营收 + 毛利率」双轴可以把两条线画成同样起伏,让毛利率看着跟营收同步暴涨,非用不可时两条轴都要标单位和量程端点,更好的做法是上下对齐共享 X 轴。
另外每张图下面必须有一行口径说明:统计周期、含不含退货、含不含未发货、金额含不含税。建材行业这三件事每家算法都不一样,不写口径的图等于埋雷。
最后是我最虚的一块,也说我为什么不把它当纯技术问题补。我能画图,但「毛利」这个词在建材行业至少三种算法——出厂价差、出厂价减返利、到岸价减返利。图上不写清是哪种,客户会拿自己心里那套来核对,然后说你数据错了。
所以我的补法是先把口径写成数据字典,再让图去读它,而不是先学一个画图技能。这也正好对上前一篇的逻辑:测试只能证明计算对,证明不了指标定义对——两个短板是叠着的,不能用其中一个盖住另一个。
我给自己定的够用标准很克制:第一版只做 4 张图——完整度堆叠、品类毛利排行、经销商对比、RFM 九宫格,全部静态图、口径行和图例齐全。不做 BI 平台、不做交互探索、不做实时大屏。这套东西补完,我对外讲的就是一句真话:我能把「哪类货赚钱、哪个经销商拖后腿、哪批客户要流失、哪里数据根本不够算」这四件事画出来,而且能保证不该被误读的地方不会被误读。
这些数字(33,176 笔订单 / 387 个经销商 / 2,799 个型号 / 97% 无尺寸)是怎么被盘出来的,在 19 · 怎么读懂 AI 写的代码 与 19-deep(危险信号清单、N+1 与异常处理的坏味道);
数据怎么存、JSON blob 为什么该拆表,在 16 · 数据库存东西 与 16-deep;
出图那部分依赖的渲染链路(sharp / ffmpeg / 程序化出帧)和它对「我敢交付」的意义,在 19-deep 的依赖三层追法一节。